选择录音
支持常见音频格式。手机或内存较小的电脑建议先处理较短文件,并使用均衡模式。
音频转文字工具
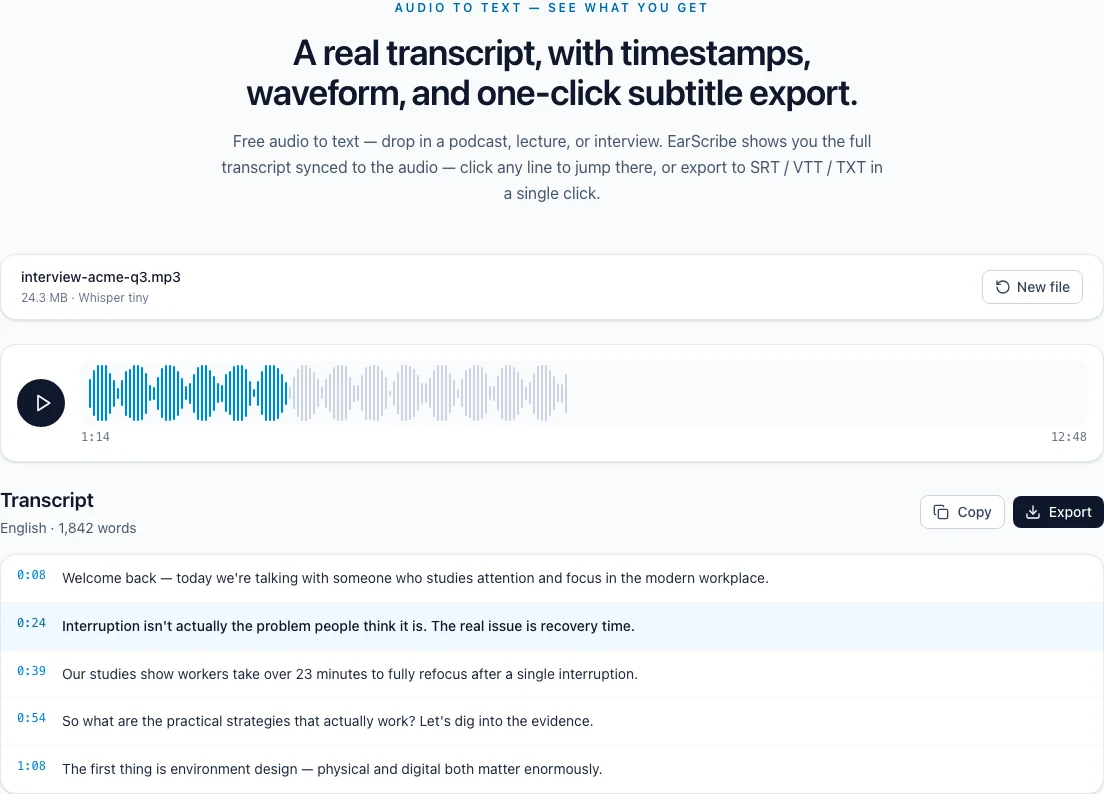
选择 MP3、WAV、M4A、FLAC、OGG 或 WebM 录音,EarScribe 会自动识别语言,生成带时间戳的文字。你可以搜索、修改、点击回听,再导出需要的格式;音频无需上传。
导出前先核对文字和时间戳
支持常见音频格式。手机或内存较小的电脑建议先处理较短文件,并使用均衡模式。
大多数录音直接使用均衡模式即可;需要更快或更高精度时,再展开高级选项。
搜索内容,修改人名和专业词,点击时间戳回听存疑片段,然后导出到剪辑、笔记或字幕工具。
音频转文字
真正能交付的文字稿,需要能回到原音核对。找到一句话、点击时间戳回听、改好人名和数字,再导出到下一步工具,才是完整流程。
MP3、WAV、M4A、FLAC、OGG 和 WebM 都可以直接选择。人声清楚、麦克风距离合适,通常比盲目换更大的模型更重要。
首次运行需要下载所选 Whisper 模型,之后浏览器可能复用缓存。长录音能否顺利处理取决于设备可用内存,先裁掉大段静音往往更实际。
搜索人名、数字或关键词,点击旁边的时间戳回听对应片段。这样可以快速发现看起来合理、实际却识别错的词。
准备发布或引用时,要重点核对人名、日期、价格和专业术语。EarScribe 帮你定位证据,但重要内容仍需要人工复核。
TXT 适合笔记和研究,SRT 或 VTT 适合字幕,JSON 保留分段和时间信息,方便接入其他流程。
工作台里的修改会同步到复制和导出,不需要分别修好几份下载文件。
导出前先核对文字和时间戳
回听所有关键人物、公司和地名。
核对日期、价格、比例和测量单位。
引用一句话前,回听它前后的完整语境。
按下一步使用场景选择 TXT、SRT、VTT 或 JSON。
人声清楚、背景噪音较少,通常比一味选择最大模型更重要。
采访录音尽量让说话人靠近麦克风,避免音乐盖住人声。
发布前重点核对人名、数字、品牌名和专业术语。
支持浏览器可以解码的常见格式,包括 MP3、WAV、M4A、OGG、FLAC 和 WebM。
不需要。Whisper 会自动识别语言,完成后可以在结果工作台查看识别结果。
可以。你可以逐段编辑、搜索全文、回听对应录音,并导出修改后的版本。