先生成采访文字稿
默认使用推荐模式。环境嘈杂的外采录音,在设备允许时可以尝试更高精度。
采访录音转文字
把媒体采访、用户访谈、口述历史和研究录音整理成带时间戳的文字。搜索主题,点击回到原录音,核对关键信息,再导出干净的文字稿。
导出前先核对文字和时间戳
默认使用推荐模式。环境嘈杂的外采录音,在设备允许时可以尝试更高精度。
搜索文字,点击时间戳,并听取前后语境,再决定是否引用。
修正人名、机构、数字和专业术语,然后导出用于笔记、研究编码或发表。
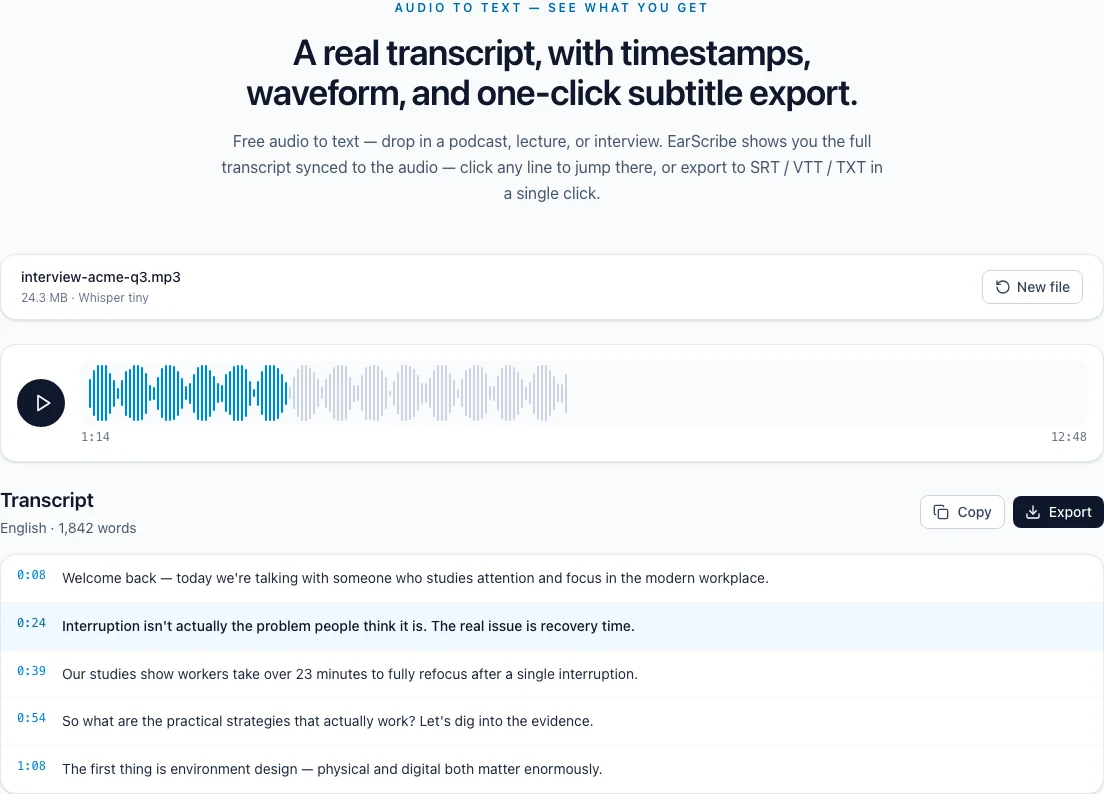
采访录音转文字
采访转写不是文字出现就结束。真正有价值的是找到观点、回听前后语境,并修正会改变原意的人名、数字和术语。
按主题、产品名或反复出现的词搜索,点击时间戳回到原始回答,避免只依赖脱离语境的短句。
用于报道和研究时,建议把原始录音和编辑稿一起保留。文字稿是检索和整理层,不是自动生成的可直接发表引语。
计划引用一句话时,先回听它前后的回答。说话人离麦克风较远或多人重叠时,尤其要核对人名、组织、日期和数据。
EarScribe 不会自动区分说话人。最终稿需要说话人标签时,请在核对过程中手动补充。
TXT 适合阅读稿,JSON 保留分段时间信息,SRT/VTT 适合采访视频字幕。
本地处理减少未公开采访上传到外部服务的需要,但仍应遵守团队或研究项目的同意、留存和设备管理规则。
导出前先核对文字和时间戳
搜索原句并先保存时间戳。
听完前后语境,避免断章取义。
人工核对人名、机构、数字和专业词。
需要说话人标签时手动添加,工具不会自动区分。
目前不会自动区分说话人,重要位置需要手动补充姓名。
标点主要用于帮助阅读,不能替代对说话人原意的核对。
采访授权、保存期限和公开范围,应独立于转录工具进行管理。
目前不能。文字稿会保留时间戳,但暂不提供说话人分离和自动姓名标签。
不建议。引语、人名、数字以及可能改变含义或归属的内容都应回听确认。
选中的音频会在浏览器中处理,不会上传到 EarScribe 服务器。模型和统计信息边界请查看隐私页。