选择音频文件
EarScribe 在浏览器里解码 MP3、WAV、M4A、OGG、FLAC 和 WebM,再把 16 kHz 单声道音频交给 Whisper。
Whisper 在线
EarScribe 借助 Transformers.js 和 ONNX Runtime Web,直接在浏览器标签页里运行 OpenAI 开源的 Whisper 模型。选好模型和音频文件,就能得到 Whisper 带时间戳的转写结果,不用装 Python,也不用为 API 付费。
导出前先核对文字和时间戳
EarScribe 在浏览器里解码 MP3、WAV、M4A、OGG、FLAC 和 WebM,再把 16 kHz 单声道音频交给 Whisper。
大多数录音推荐 Base。也可以对比四个模型,在下载体积、速度和准确率之间取舍。
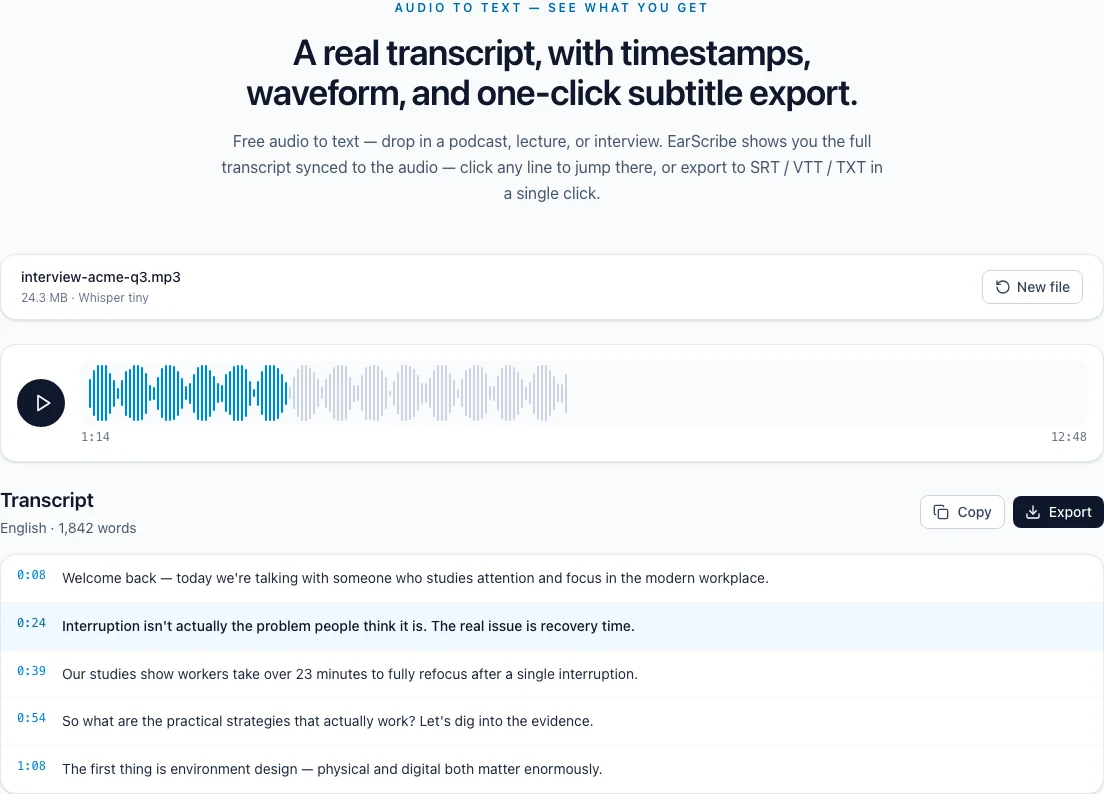
每一段都带有 Whisper 给出的时间戳,可以回听、修改,并导出 TXT、SRT、VTT 或 JSON。
whisper 在线
Whisper 是 OpenAI 在 2022 年开源的一系列语音识别模型,用 68 万小时的多语言音频训练。模型大小是最主要的取舍:越大越准,运行也越吃力。
Tiny(3900 万参数)最快、下载最小,适合手机和快速出草稿。Base(7400 万参数)是清晰人声的推荐选择。Small(2.44 亿参数)更能应付口音和噪音,但需要更多内存,最好有 WebGPU。
Large v3 Turbo(8.09 亿参数)是 Whisper 最大模型的提速版,解码器从 32 层缩减到 4 层。它是这里最准的选项,需要性能较好的设备,建议有约 6 GB 内存和 WebGPU。
浏览器支持 WebGPU 时,模型在显卡上运行,大模型会快很多;不支持时,EarScribe 改用 CPU 上的 WebAssembly,几乎哪里都能跑,只是更慢。
较新版本的 Chrome 和 Edge 已支持 WebGPU,其他浏览器也在陆续跟进。如果 Small 或 Large v3 Turbo 感觉很慢,通常是走了 CPU。
在静音或音乐段,Whisper 可能生成看似合理的文字、重复某句话,或在多人抢话时漏词。它也不会标注说话人。
时间戳是按段落给出的,不是逐字。发布前,用它们跳回原音频核对重要内容。
导出前先核对文字和时间戳
从 Tiny 或 Base 开始。
Base 通常就够。
在 4 GB 以上内存的设备上试试 Small。
Large v3 Turbo,搭配 WebGPU 和 6 GB 以上内存。
Whisper 根据前 30 秒判断语言,文件开头最好是人声,而不是很长的片头音乐。
静音和音乐可能让 Whisper 凭空生成短句,剪掉长静音,并检查文字稿的开头和结尾。
大模型主要在口音、噪音和专业词汇上更有优势;清晰人声用 Base 往往就够了。
是的。EarScribe 使用 onnx-community 在 Hugging Face 上发布的 ONNX 版 Whisper 权重,通过 Transformers.js 运行。模型相同,只是运行环境不同。
Tiny、Base、Small 和 Large v3 Turbo。开始前,模型选择器会显示每个模型的下载大小和内存建议。
API 需要把文件上传到 OpenAI、要有 API Key,并按音频时长计费。这里模型在你的设备上运行,没有 Key 也没有费用,但速度取决于你的硬件。
浏览器第一次要下载模型并缓存,之后在同一台设备和浏览器上启动会快很多。