浏览器读取文件
录音从本地磁盘打开,由浏览器自带的音频引擎解码,不会上传。
本地语音转文字
EarScribe 在浏览器标签页里解码并转写你的录音,文件不会发送到任何服务器,唯一较大的下载是语音模型,浏览器会把它缓存起来。这里说明哪些内容留在你的设备上、页面会发送什么,以及怎样自己动手验证。
导出前先核对文字和时间戳
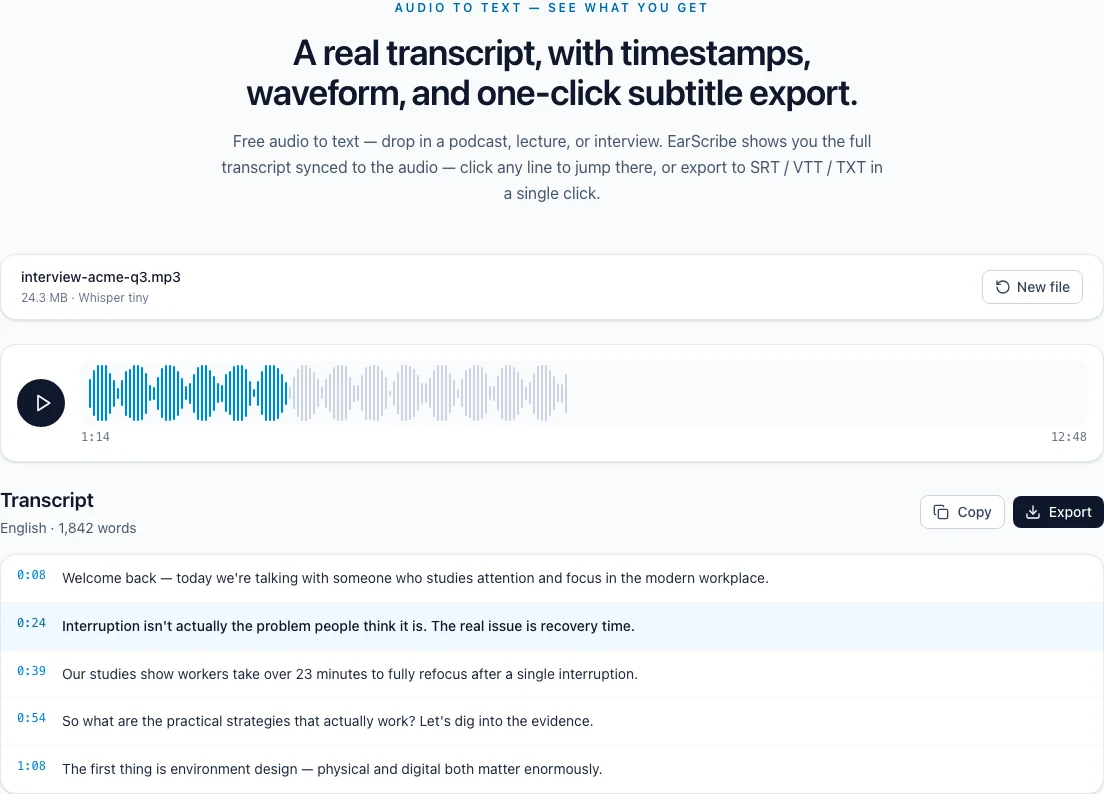
录音从本地磁盘打开,由浏览器自带的音频引擎解码,不会上传。
Whisper 通过 Transformers.js 和 ONNX Runtime Web 在后台 Web Worker 中运行,使用 WebGPU 或 CPU。
文字稿显示在页面上,草稿保存在当前浏览器的存储里,直到你清除为止。
本地语音转文字
大多数在线转写服务会把你的文件上传到它们的服务器。EarScribe 反过来做:把模型带到你的浏览器里,录音留在原地。
留在设备上的:音频文件、解码后的音频、文字稿、你的修改和导出的文件。会经过网络的:页面本身、首次使用时的 Whisper 模型文件、“转写完成”之类的汇总统计事件(不含文件名和文字),以及隐私政策中说明的 Google 广告脚本。
模型下载约 80 MB 到 800 MB(取决于模型),会被浏览器缓存,同一台设备之后使用时就不用再下载。
在 Chrome 或 Edge 里按 F12(Mac 上按 Option+Command+I)打开“网络”(Network)面板;Safari 需要先打开“开发”菜单。清空列表,选择文件并转写。第一次会看到模型文件的请求,但不会有大小和你录音相当的请求。
按大小排序会更直观。想更严格地验证,可以先转写一次让模型缓存,再刷新页面,观察处理第二个文件时的网络请求。
本地转写适合不能或不想交给第三方的录音:保密采访、内部会议、知情同意书排除了外部服务的研究访谈,或者个人笔记。
它本身不能让设备变安全。恶意软件、浏览器扩展和共用账户仍然能看到你打开的内容,所以对文字稿要和对录音一样小心。
导出前先核对文字和时间戳
使用没有多余扩展的浏览器配置。
需要证据时,观察一次“网络”面板。
在公用设备上清除网站数据,删掉保存的草稿。
把导出的文字稿存在规定允许的位置。
浏览器扩展可以读取页面上显示的内容,处理敏感录音时请使用干净的浏览器配置。
导出的文件和保存的草稿都在这台设备上。在公用电脑上用完请删除,并清除网站数据。
即使没有上传,也请遵守所在单位对保密材料的规定。
不会。文件在浏览器标签页里读取和处理,EarScribe 的服务器既收不到录音,也收不到文字稿。
页面本身的代码、首次使用时的 Whisper 模型(通过 EarScribe 的模型代理下载)、不含文件名和文字内容的 Plausible 汇总统计事件,以及 Google 的广告脚本。这些请求都不包含你的音频。
它不是安装式的离线软件。打开页面和第一次下载模型都需要联网,但转写本身从不依赖服务器。
打开浏览器开发者工具,切到“网络”(Network)面板,然后转写一个文件。第一次会看到模型文件的下载,但不会有携带你录音的请求。