先看文件大小
一小时 CD 音质的立体声 WAV 约 635 MB,超过 1 GB 的文件会被拒绝。长录音请先拆分,或导出一份单声道副本。
WAV 转文字工具
录音笔、音频工作站和 Audacity 导出的通常是 WAV:不压缩,体积很大。EarScribe 在你自己的设备上读取 WAV,大文件不必上传,直接生成可以核对和导出的带时间戳文字。
导出前先核对文字和时间戳
一小时 CD 音质的立体声 WAV 约 635 MB,超过 1 GB 的文件会被拒绝。长录音请先拆分,或导出一份单声道副本。
大多数录音用均衡模型即可。内存紧张时用 Tiny,大模型需要更多内存。
从时间戳回听没把握的句子,改正后导出需要的格式。
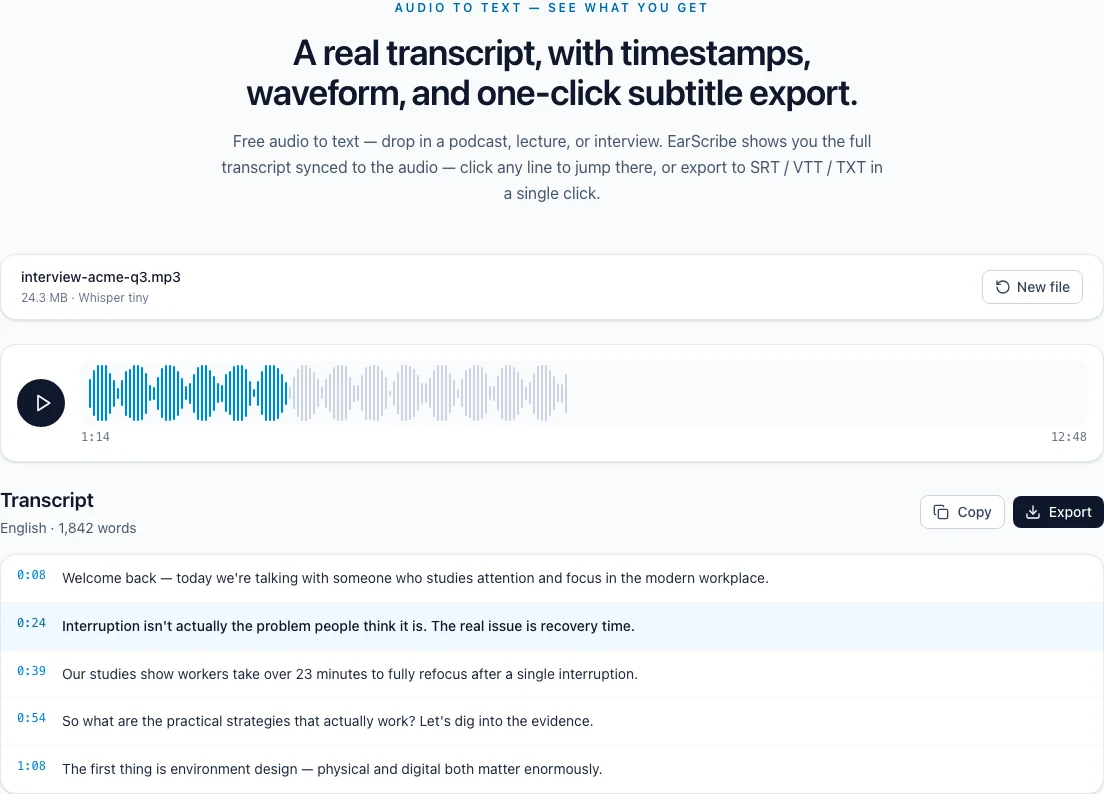
wav转文字
WAV 通常是不压缩的 PCM 音频,解码容易,但很占内存。真正要提前规划的是文件大小,转写本身反而是简单的部分。
CD 音质的立体声 WAV(16-bit、44.1 kHz)每分钟约 10.6 MB,24-bit、48 kHz 立体声每分钟约 17.3 MB,大约一小时就会达到 EarScribe 1 GB 的文件上限。16 kHz、16-bit 单声道 WAV 每分钟不到 2 MB,语音识别需要的信息一点不少。
EarScribe 会在浏览器里解码整个文件,并转成 16 kHz 单声道交给 Whisper。文件不上传,但浏览器要同时存放原文件和解码后的音频,所以长时间的高规格 WAV 在手机上容易失败。
录音超过一小时,或者是 24-bit、48 kHz 立体声时,先在剪辑软件里导出 16 kHz 单声道 WAV 或高质量 MP3 再转写。模型用得到的信息不会损失。
原始 WAV 留作剪辑和归档的母版。只要副本的起点相同,文字稿的时间戳就和原文件对得上。
识别前两个声道会合成一个。如果两个人分别录在左右声道,文字稿仍然是一段连续对话,不会标注说话人。
分轨录制的播客或采访,写节目笔记时转写最终混音即可;需要准确区分谁说了什么时,再逐个音轨单独转写。
导出前先核对文字和时间戳
在手机和低内存电脑上,超过一小时的录音先拆分。
使用标准 16-bit 或 24-bit PCM WAV,压缩变体先转换。
原文件太大时转写 16 kHz 单声道副本,原文件保留。
导出前回听人名、数字和专业术语。
高于 16 kHz 的采样率和 24-bit 位深不会让 Whisper 更准,识别前音频都会转成 16 kHz 单声道。
人声用单声道就够了。立体声的两个声道会在转写前合成一个声道。
麦克风摆位和安静的环境,比更高规格的文件更能提升效果。
通常差别不大。Whisper 处理的是 16 kHz 单声道音频,清晰人声的高质量 MP3 识别效果差不多。WAV 主要在嘈杂录音不宜再压缩时更有优势。
EarScribe 接受 1 GB 以内的文件,真正的上限是设备内存。浏览器要同时保存原文件和解码后的音频,一小时的立体声 WAV 可能需要超过 1 GB 内存。更长的录音请拆分,或导出 16 kHz 单声道副本。
标准 PCM 格式的 WAV 主流浏览器都能打开。有些录音设备和电话系统会在 WAV 里存放 ADPCM 等压缩编码,请先转成 16-bit PCM WAV 或 MP3。
请先导出一个混音后的 WAV;如果需要准确知道谁说了什么,就每个音轨单独导出一个文件。EarScribe 每次处理一个文件。