生成带时间轴的字幕
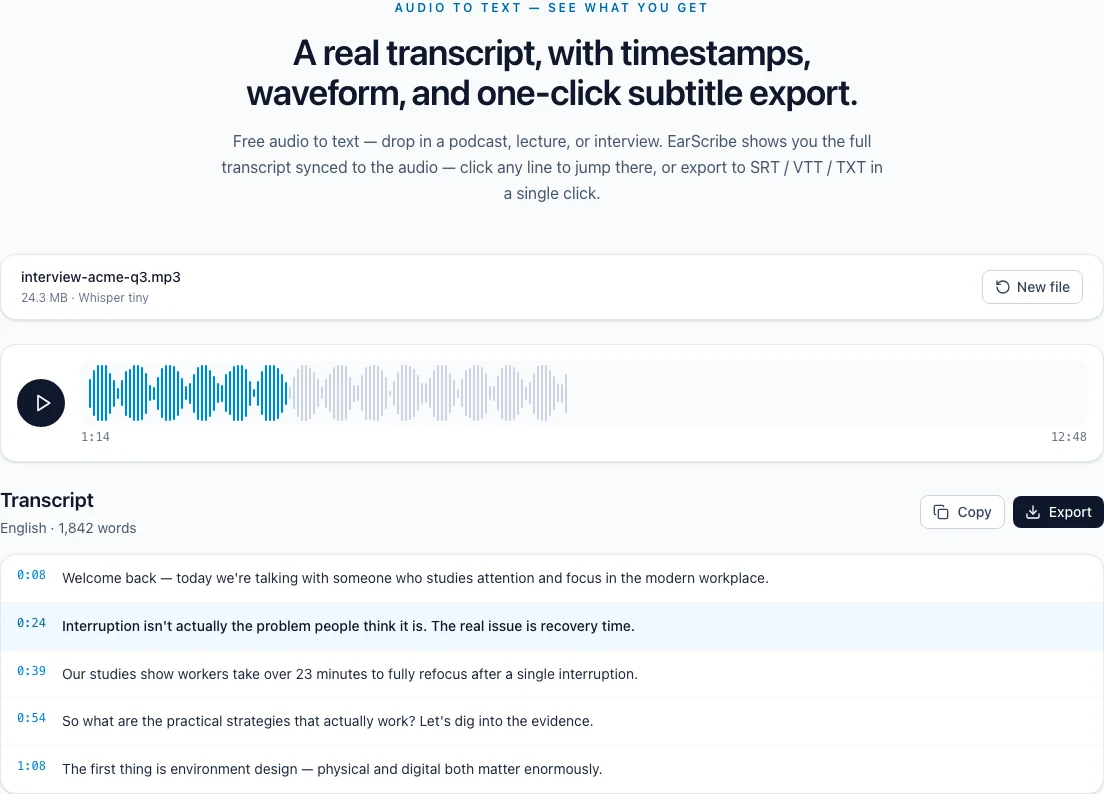
识别音频,并保留模型为每个片段生成的时间范围。
音频转 SRT 字幕工具
从 MP3、WAV、M4A 等音频生成 SRT 或 VTT。EarScribe 会保留 Whisper 时间戳,标出常见的可读性问题,并在导出前帮助你优化断行。
导出前先核对文字和时间戳
识别音频,并保留模型为每个片段生成的时间范围。
集中检查过长、阅读过快、重复、空白或时间重叠的字幕。
优化断行,回听重点片段,再导出 SRT 或 VTT 到剪辑软件和视频平台。
音频转SRT
自动生成字幕只是第一步。真正能交付的 SRT 还要检查断行、阅读速度、时间重叠,并回听模型无法从声音判断的专名和数字。
选择 MP3、WAV、M4A 等音频,EarScribe 会保留分段时间信息,同一份结果可以导出 SRT、VTT、TXT 或 JSON。
这里解决的是音频到字幕文件,不是把字幕烧录到视频里,也不是替代剪辑软件。你可以把文件交给控制画面和样式的下一步工具。
集中查看过长、阅读过快、空白、重复和时间重叠的字幕。这些问题会让观众读不完,即使单词本身识别正确。
点击字幕回听原音,修改文字后再次检查。重要视频仍应完整预览一遍。
SRT 被大多数剪辑软件和视频平台支持;VTT 更适合网页视频。只需要阅读文字时,导出 TXT 即可。
先在工作台中修改,再导出所有格式,可以让文字和时间轴保持一致。
导出前先核对文字和时间戳
过长的字幕要拆分或精简,确保正常屏幕上读得完。
回听过快片段,只在不改变原意时精简措辞。
检查空白、重复和重叠字幕。
人名、数字和专业术语不要只看字面,要回听原音。
两行短字幕通常比一整行长句更容易阅读。
语速很快时,可能需要精简文字或更合理地拆分时间段。
人名、数字和画面里的专有词,发布前应人工核对。
两者都保存带时间轴的字幕。SRT 被多数剪辑软件和平台支持;VTT 更适合网页视频,并支持更多 Web 字幕能力。
它可以优化断行并标出常见问题,但重要视频仍应完整预览,人工确认措辞和时间。
可以。先编辑带时间戳的文字,再回到字幕体检,导出更新后的 SRT 或 VTT。