音声ファイルを選ぶ
EarScribeがMP3・WAV・M4A・OGG・FLAC・WebMをブラウザでデコードし、16 kHzモノラルの音声をWhisperに渡します。
Whisper 文字起こし
EarScribeは、OpenAIがオープンソースで公開したWhisperモデルを、Transformers.jsとONNX Runtime Webでブラウザのタブ内で直接動かします。モデルと音声ファイルを選ぶだけで、Pythonのインストールや有料APIなしに、Whisperのタイムスタンプ付き文字起こしが得られます。
書き出す前に文字とタイムスタンプを確認
EarScribeがMP3・WAV・M4A・OGG・FLAC・WebMをブラウザでデコードし、16 kHzモノラルの音声をWhisperに渡します。
多くの録音にはBaseがおすすめです。4つのモデルを比べて、ダウンロード容量・速度・精度のバランスを選べます。
各区間にWhisperのタイムスタンプが付きます。聞き直して修正し、TXT・SRT・VTT・JSONで書き出します。
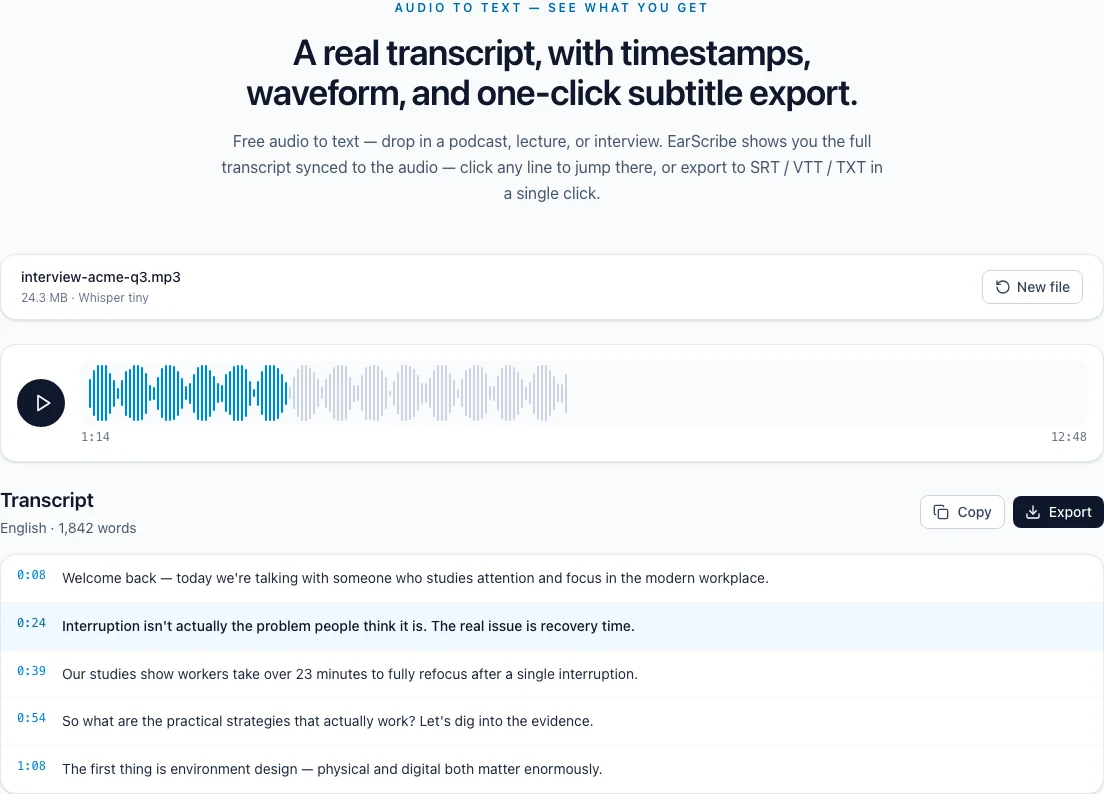
whisper 文字起こし
Whisperは、OpenAIが2022年にオープンソースで公開した音声認識モデルのシリーズで、多言語の音声68万時間で学習されています。いちばん大きな選択肢はモデルの大きさで、大きいほど正確ですが、動かすのも重くなります。
Tiny(3,900万パラメータ)は最速でダウンロードも最小なので、スマートフォンや下書きに向いています。Base(7,400万)ははっきりした声におすすめのバランス型です。Small(2億4,400万)は訛りや雑音に強くなりますが、メモリを多く使い、WebGPUがあると快適です。
Large v3 Turbo(8億900万パラメータ)は、Whisperの最大モデルのデコーダを32層から4層に減らした高速版です。ここで最も精度が高い選択肢で、約6 GBのメモリとWebGPUのある端末をおすすめします。
ブラウザがWebGPUに対応していれば、モデルはGPUで動き、大きいモデルほど速くなります。対応していない場合はCPU上のWebAssemblyに切り替わり、ほとんどの環境で動きますが遅くなります。
WebGPUは最近のChromeとEdgeで使え、ほかのブラウザでも対応が進んでいます。SmallやLarge v3 Turboが遅いと感じたら、多くの場合CPUで動いています。
無音や音楽の部分でそれらしい文を作ったり、同じフレーズを繰り返したり、発言が重なると単語を落としたりすることがあります。話者の区別もしません。
タイムスタンプは単語ごとではなく区間ごとです。公開前に、重要な箇所はタイムスタンプから聞き直して確認してください。
書き出す前に文字とタイムスタンプを確認
TinyかBaseから始める。
たいていBaseで十分。
メモリ4 GB以上の端末でSmallを試す。
Large v3 Turboを、WebGPUとメモリ6 GB以上で。
Whisperは最初の30秒で言語を判定します。長いBGMではなく、話し声から始まるファイルが向いています。
無音や音楽の部分で、Whisperが短い文をでっち上げることがあります。長い無音は削り、最初と最後を確認しましょう。
大きいモデルが効くのは訛り・雑音・専門用語です。はっきりした声ならBaseで十分なことが多いです。
はい。onnx-communityがHugging Faceで公開しているONNX版のWhisperの重みを、Transformers.jsで動かしています。モデルは同じで、実行環境だけが違います。
Tiny、Base、Small、Large v3 Turboです。開始前にモデル選択画面で各モデルのダウンロード容量とメモリの目安を確認できます。
APIはファイルをOpenAIにアップロードし、APIキーが必要で、音声の長さに応じて課金されます。EarScribeは端末上でモデルを動かすので、キーも料金も不要ですが、速度はハードウェア次第です。
ブラウザが最初にモデルをダウンロードしてキャッシュするためです。同じ端末とブラウザなら、2回目以降はずっと速く始まります。